
Microsoft, è tempo di Maia 300, il chip di nuova generazione per l’AI
 Redazione ChannelCity
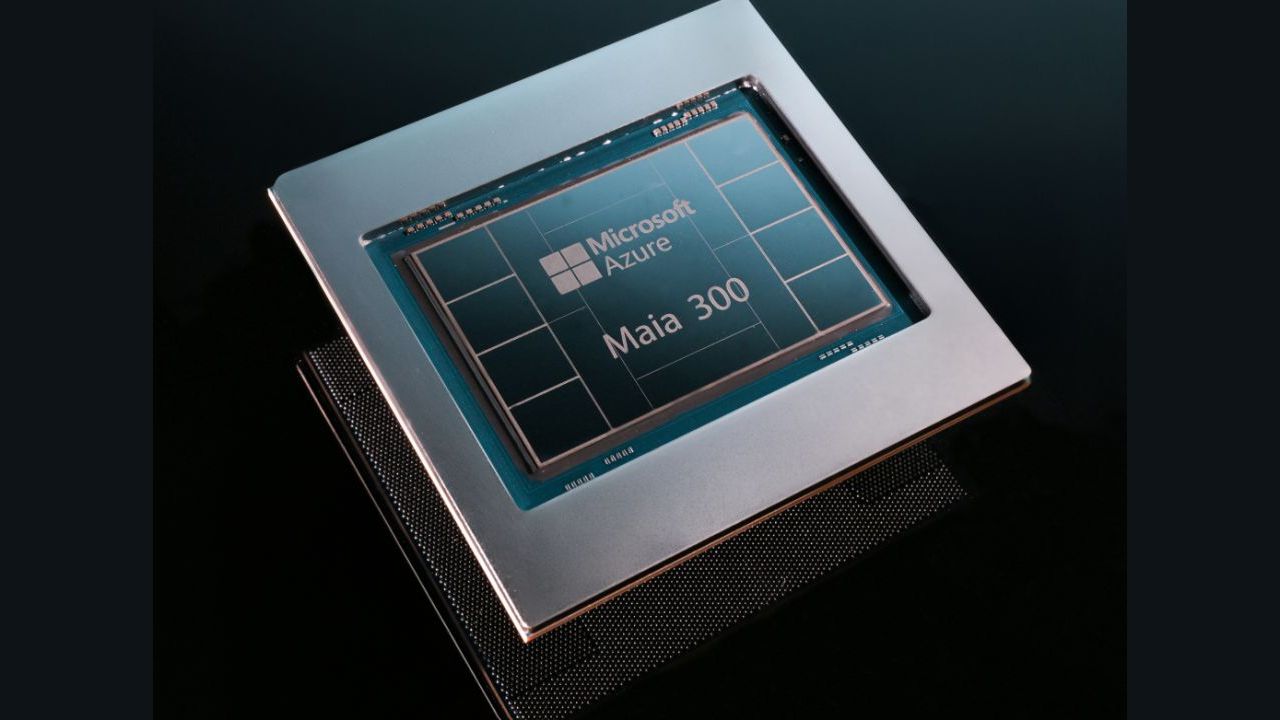
Maia 300 rappresenta un’ulteriore evoluzione dell’approccio sistemico di Microsoft all’infrastruttura AI.


Microsoft ha lanciato Maia 300, il chip di nuova generazione progettato per l’inferenza AI, e ha annunciato l’espansione dell’infrastruttura Azure basata sugli acceleratori Maia, con implementazioni su scala multi-gigawatt a partire dal 2027. Con questo rollout, Maia 300 diventerà il principale sistema di inferenza AI per i prodotti e i servizi Microsoft.
A meno di un anno dalla presentazione di Maia 200, Maia 300 rappresenta un’ulteriore evoluzione dell’approccio sistemico di Microsoft all’infrastruttura AI. Ecco in sintesi le principali novità:
Partecipa agli ItalianChannelAwards 2026 vota le eccellenze dell’Ict! Esprimi il tuo voto premiando i migliori in molteplici categorie
- Il sistema Azure Maia è progettato sulla base dei carichi di lavoro reali che Microsoft gestisce su larga scala e delle nuove tipologie di workload AI che stanno emergendo oggi: ragionamento su contesti estesi, esperienze conversazionali sensibili alla latenza e attività agentiche prolungate e articolate in più passaggi.
- Grazie a un miglioramento dell’efficienza dell’intero sistema, Microsoft prevede che Maia 300 possa generare il 40% di token in più per megawatt rispetto ai principali sistemi basati su GPU. Inoltre, in una configurazione completa con 96 acceleratori, Maia 300 sarà in grado di elaborare, a livello di rack, fino a 7 volte più token rispetto a Maia 200.
- Maia 300 valorizza gli insight derivanti dalla gestione su larga scala dei servizi AI di Microsoft, consentendo una co-progettazione unica tra sistemi hardware e applicazioni software. Questo approccio si basa sull’esperienza di Maia 200, attualmente in fase d’implementazione negli Stati Uniti, in Europa e in Australia, che offre fino a 1,7 volte più token per watt per le funzionalità AI integrate in Microsoft Teams, Copilot e nelle esperienze Cowork utilizzate ogni giorno da centinaia di milioni di persone.
- Insieme, Maia 200 e Maia 300 sono progettati per supportare un’ampia gamma di ulteriori servizi AI Microsoft: attività agentiche multi-step, che aiuteranno GitHub a offrire esperienze di coding in modo più efficiente; erogazione di modelli su scala cloud, che consentiranno a Microsoft Foundry di supportare diverse architetture e ambienti di deployment; inferenza e generazione di dati a supporto del team AI di Microsoft; e interazioni sensibili alla latenza, che richiedono tempi di risposta molto rapidi e permetteranno a Dragon Copilot di ampliare i workflow e ridurre il carico amministrativo dei professionisti sanitari.
Tag correlati
Esplora altri articoli su questi argomenti
Se questo articolo ti è piaciuto e vuoi rimanere sempre informato
Notizie correlate



Speciali Tutti gli speciali
Calendario Tutto
Magazine Tutti i numeri
G11 Media Networks

ChannelCity e' un canale di BitCity, testata giornalistica registrata presso il tribunale di Como ,
n. 21/2007 del
11/10/2007- Iscrizione ROC n. 15698
G11 MEDIA S.R.L.
Sede Legale Via NUOVA VALASSINA, 4 22046 MERONE (CO) - P.IVA/C.F.03062910132
Registro imprese di Como n. 03062910132 - REA n. 293834 CAPITALE SOCIALE Euro 30.000 i.v.
